

News
A Learning Healthcare System for Better Cancer Research and Care
Vast amounts of data are generated during cancer diagnosis and treatment every single day. Tissue samples are analyzed, data about the tumor genomes is acquired, treatments are prescribed, and outcomes are monitored. The insights this data provides are valuable for individual patients, but – while respecting patients’ rights and choices regarding the use of their data – also has potential to drive research and innovation to improve care for future patients. Improving this ‘data loop’ is a shared mission for Hartwig Medical Foundation and the Oncode Accelerator Patient Cohorts Platform. Together, they aim to transform routine cancer care into a learning healthcare system that accelerates research, improves treatment decisions, and delivers better cancer care for future patients.
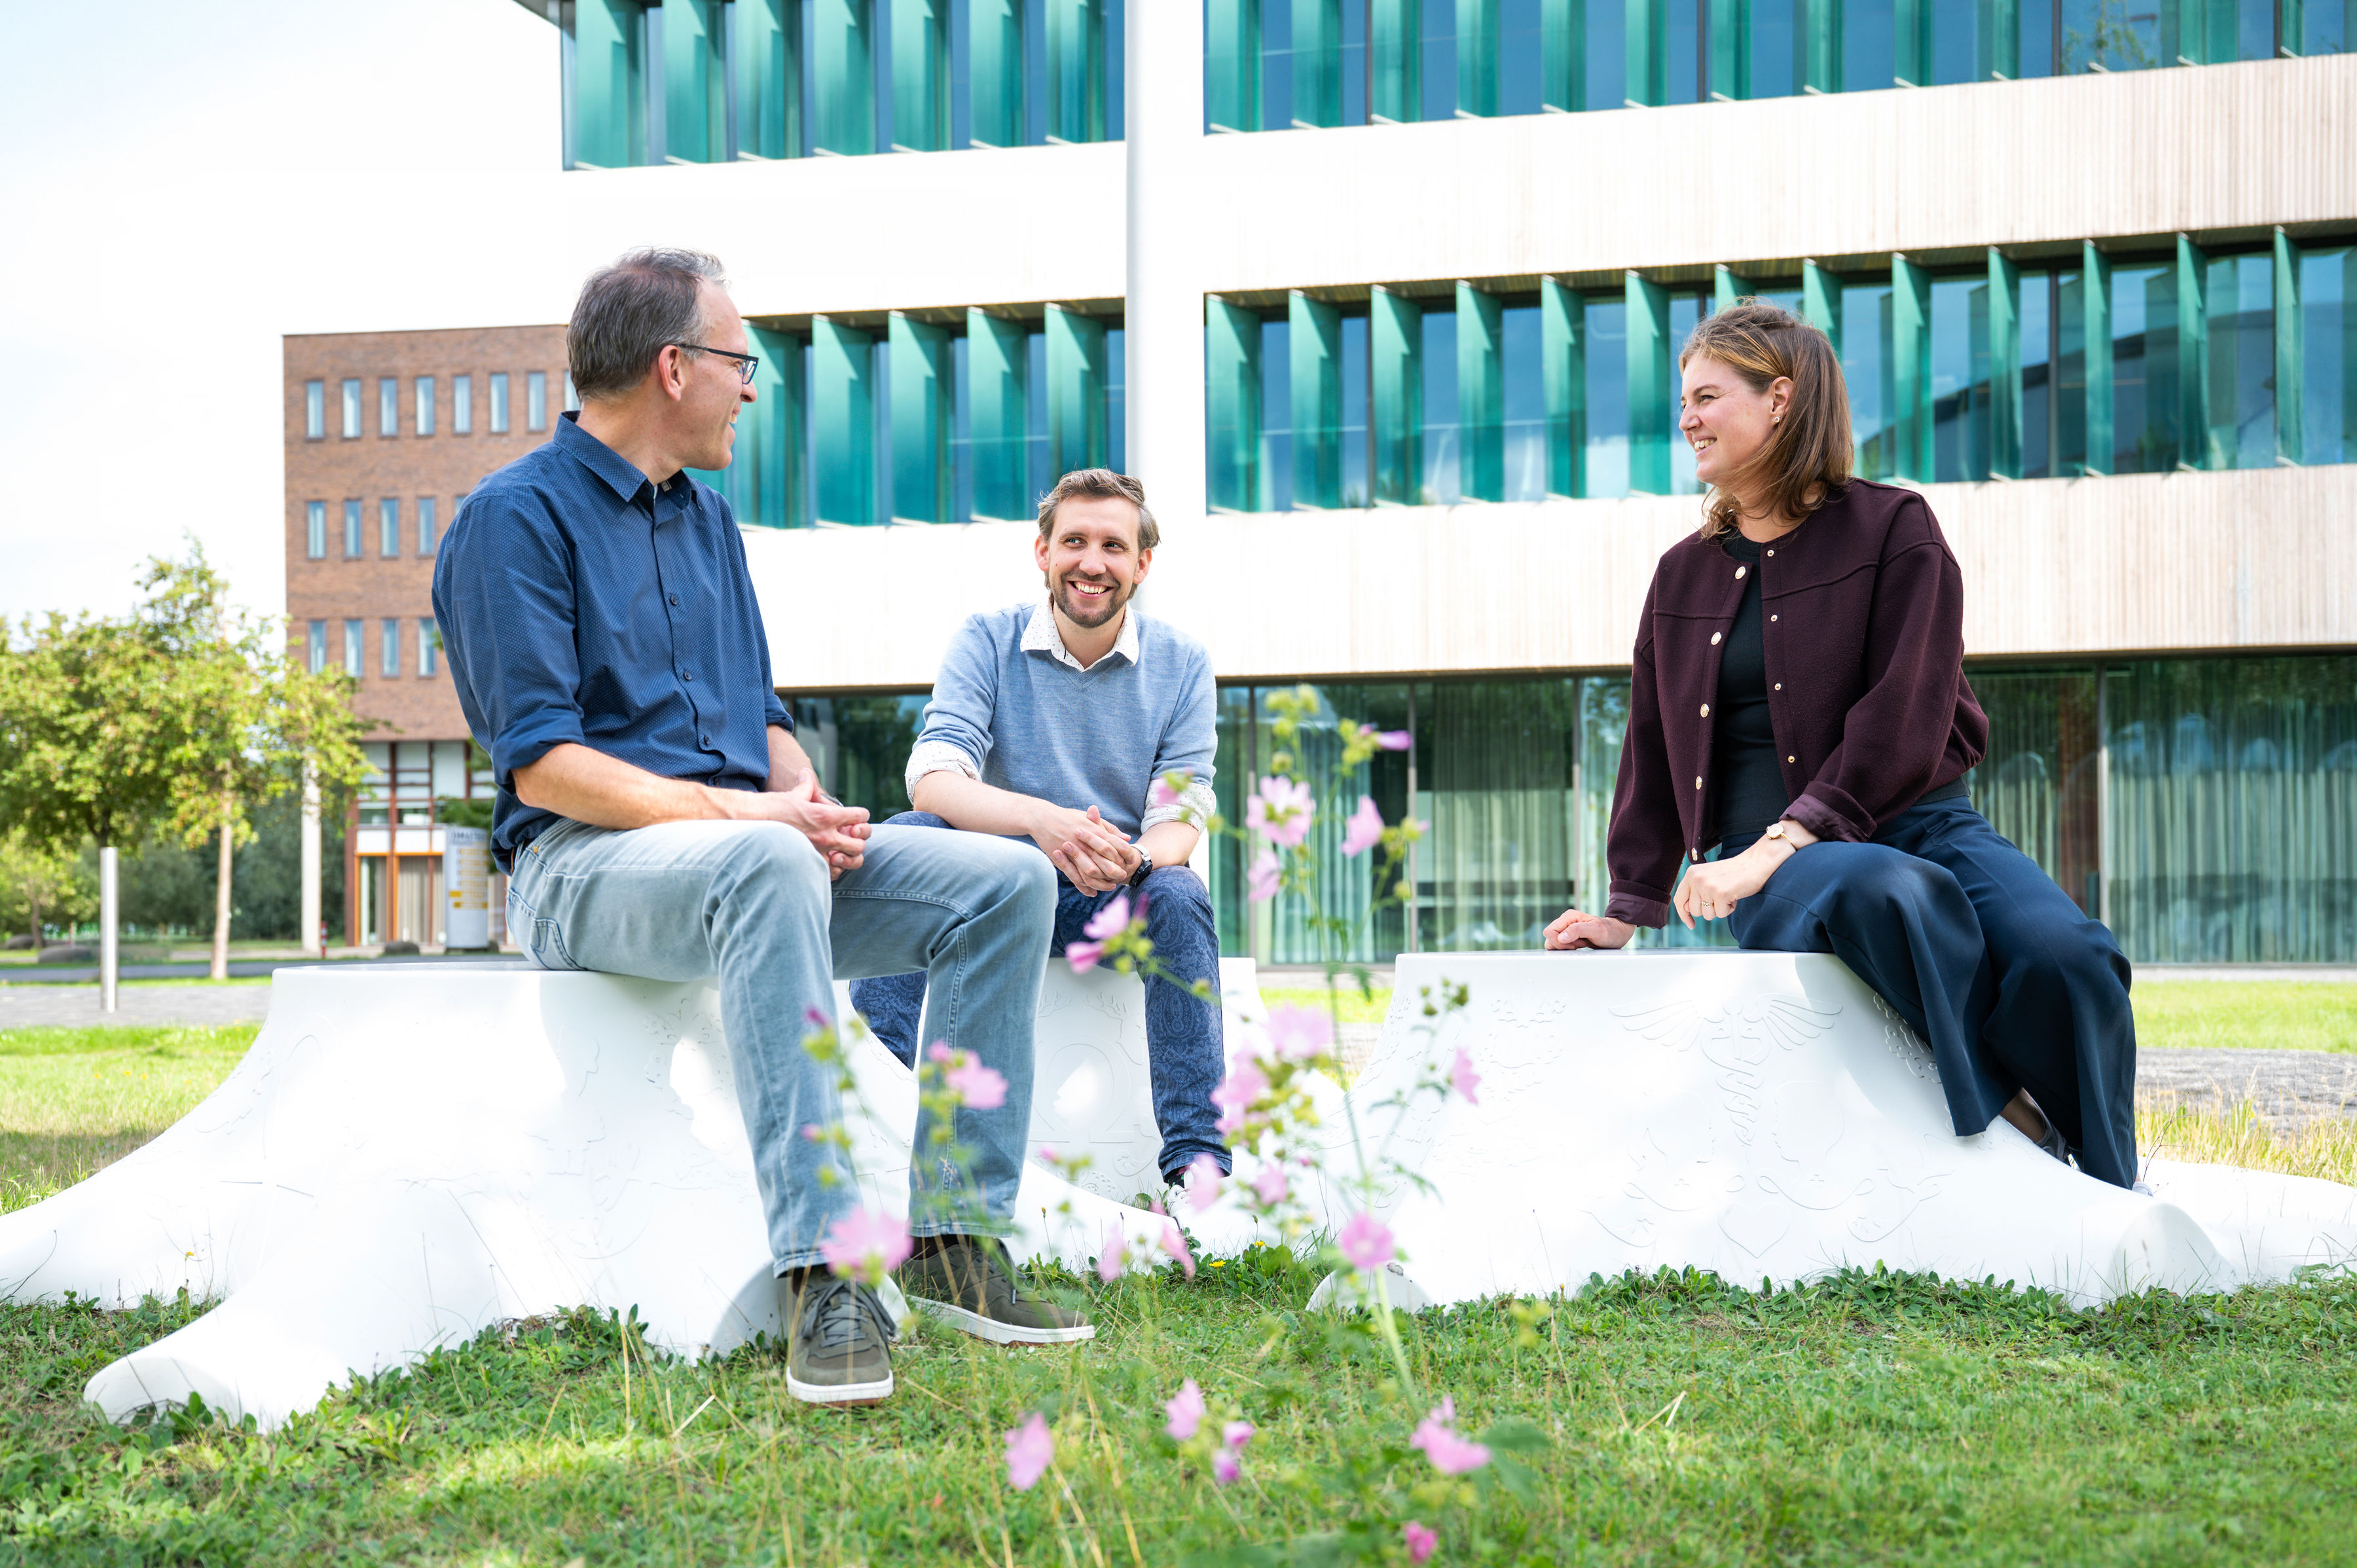
One day, we could have a learning healthcare system where every patient helps improve cancer care for the next. That is a vision that Hartwig Medical Foundation and the Oncode Accelerator Patient Cohorts Platform share. They collaborate to connect data across the full course of cancer care, including longitudinal clinical and outcome data, genomic information, and quality-of-life data, so that it can both guide diagnosis and treatment and advance research and development of new therapies.
We spoke to Paul Roepman (Clinical Molecular Biologist, Hartwig Medical Foundation), Joep de Ligt (Database Lead, Hartwig Medical Foundation), and Elise Rinzema (Program Manager, Patient Cohorts Platform of Oncode Accelerator) to learn more.
“Each of us contributes a different piece of the puzzle,” explains Elise. The Patient Cohorts Platform brings together 12 national oncology cohorts, which collect high-quality clinical data and biomaterials from cancer patients across the Netherlands. Hartwig Medical Foundation specializes in complete genomic profiling of the cancer and translating this complex molecular data into information that is meaningful for doctors, patients, and researchers. Paul adds, “Hartwig Medical Foundation is a technology institute. We rely on partnerships with hospitals – and preferably at scale like with the Patient Cohorts Platform, because the numbers matter.”
From Routine Care to a Learning Healthcare System
“In every hospital there is so much data available. Ideally you can get insights from it to improve research and future healthcare, then improve treatments for future patients, and then learn again from the patients receiving those improved treatments,” says Elise. “But research and routine care often operate separately. Bringing them together requires coordination and trust.”
Elise Rinzema, Program Manager, Patient Cohorts Platform of Oncode AcceleratorIn every hospital there is so much data available. Ideally you can get insights from it to improve research and future healthcare, then improve treatments for future patients, and then learn again from the patients receiving those improved treatments. But research and routine care often operate separately. Bringing them together requires coordination and trust.
For example, diagnostic information helps guide decisions for individual patients, but its potential to generate new insights and improve treatments for future patients is not always fully realized. While clinical trials will remain key for the development of new treatments, a learning healthcare system aims to complement them by learning systematically from all patients receiving care in everyday clinical practice.
“In an ideal situation, you learn from every patient,” says Paul. “In a learning healthcare system, we want to know whether a treatment worked, for whom, and why. Those insights should feed back into research and care so we can learn from our successes and mistakes and improve care for future patients.”
Closing the Data Loop
Closing this data loop between care and innovation is a necessary step toward creating a learning healthcare system. “It is about ensuring that data generated during care makes it back to feed into research, clinical trials, and re-evaluation of drugs,” explains Joep. “For example, data from different hospitals about how long patients survive after a certain treatment needs to be collected, centralized, and analyzed to find out how well the treatment worked. And then the findings of that re-evaluation should cycle back into treatment guidelines.”
Joep de Ligt, Database Lead, Hartwig Medical FoundationClosing the data loop is about ensuring that data generated during care makes it back to feed into research, clinical trials, and re-evaluation of drugs. For example, data from different hospitals about how long patients survive after a certain treatment needs to be collected, centralized, and analyzed to find out how well the treatment worked. And then the findings of that re-evaluation should cycle back into treatment guidelines.
Paul and Joep share two examples that show how this feedback loop can benefit patients. The first example is the case of PARP inhibitors, a treatment for patients with breast or ovarian cancer. “Traditionally, PARP inhibitors were thought to work best for patients with breast or ovarian cancer with mutations in the BRCA genes. This was also reflected in their drug label,” explains Paul. “But by analyzing whole genome sequencing data from patients, we learned that PARP inhibitors work well against tumors that have a large number of DNA breaks, which can be, but are not exclusively, caused by defects in BRCA genes. PARP inhibitors work less well for tumors that don’t have many DNA breaks, even if they do have a BRCA mutation.” This new understanding will help doctors make better treatment decisions in the future, and adjust drug labels.
A second example is Cancer of Unknown Primary (CUP): cases where cancer has spread but its origin can’t be identified. This used to mean there was no standard treatment available, because treatment regimens, including chemotherapies, are matched to the original tumor site. “Using whole genome sequencing data, we can now get a better understanding of where the primary tumor is in about three out of four patients with CUP,” Paul explains. This approach, which is now reimbursed in Dutch care, opens up treatment possibilities for patients who otherwise had none.
Where the Data Loop Still Breaks
For researchers to draw conclusions, both biological samples and clinical information must meet high quality standards. For biological samples, the method of collection and storage is key. For example, routine histopathology requires sample processing using formalin fixation for microscopic investigation – but this process damages DNA, making those samples less suitable for genomic analysis. Data from biological samples and associated clinical data from the same patient also need to be linked, so that it is clear which samples come from which patient.
When it comes to clinical data, it’s important for information to be recorded in a way that is accurate, complete, and standardized. “If survival or treatment data is inaccurate or incomplete,” Joep explains, “researchers risk drawing the wrong conclusions.”
Data standardization is also critical to ensure that data from different hospitals can be combined effectively. “We all need to speak the same language,” says Elise. “By being able to combine different datasets, the data becomes much more valuable.” For instance, data standardization makes it easier to study rare cancers or specific subgroups of patients, such as those with particular molecular profiles or treatment responses for which the total amount of data may be very limited. Making data from different sources compatible so it can be easily combined and analyzed can bring together information from enough patients in the Netherlands, or globally, to generate meaningful evidence.
Making Complex Data Understandable
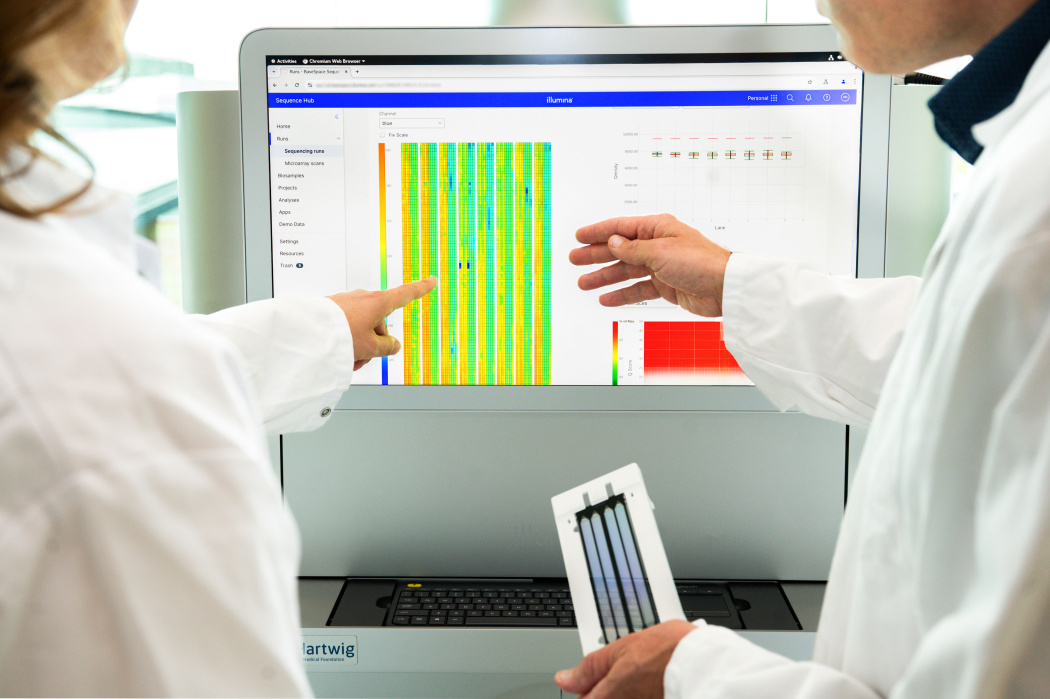
Each whole genome sequencing dataset contains a vast amount of information. Paul comments: “Part of my role is to make sure that the generated genomic data and results are in line with what hospitals need, want, and can cope with, to support – and not confuse – doctors in having a useful discussion with their patients in the consultation room. We typically report and prioritize results for a subset of about 500 cancer-related genes and genome-wide markers, such as tumor mutational burden and microsatellite instability, to make the amount of information manageable.”
Paul Roepman, Clinical Molecular Biologist, Hartwig Medical FoundationPart of my role is to make sure that the generated genomic data and results are in line with what hospitals need, want, and can cope with, to support – and not confuse – doctors in having a useful discussion with their patients in the consultation room.
Why only report these selected markers and treatment-associated findings, and not everything? “If you were to try to take a look at all the data generated from whole genome sequencing, that would take days for even an expert,” explains Joep. “We need Paul’s team to help us define what’s clinically relevant. For example, if the number of genetic mutations is predictive of whether an immunotherapy will work for a patient, that’s important information. But a clinician doesn’t want to see a raw number, they want to know: will this therapy help my patient?”
To help researchers and clinicians navigate those large datasets and answer practical questions like which therapy will work for which patient, Joep’s team at Hartwig Medical Foundation is developing new tools, such as AI assistants that help researchers and doctors use the available data to answer their questions.
Importantly, these data analysis and visualization tools are designed with privacy in mind. “Our AI assistant helps answer questions based on the data that is available, but it never accesses patient data directly,” explains Joep. This ensures compliance with strict data protection requirements and honors the patients’ consent and right to withdraw their data. The aim is to make the data easier to analyze without compromising security or patient privacy.
Building the Future Together
Closing the data loop requires top technology and expertise, but also trust and collaboration. Standardizing data, aligning systems, and creating common frameworks across so many diverse partners can be painstaking work, but the potential rewards are great.
Individually, Hartwig Medical Foundation and the Patient Cohorts Platform each have different pieces of the puzzle. But together, they can close the data loop and build a healthcare system where every patient contributes to better care for the next.
Photo credit: Laloes Fotographie
About Hartwig Medical Foundation (Hartwig)
Hartwig Medical Foundation is a Dutch nonprofit organization that operates globally with the mission to improve cancer patient care. They support data-driven treatment decisions through a combination of innovative software, clinical data analyses, and molecular diagnostics. This enables patients to timely receive the right treatment, while generating valuable data that supports research, drug development and the continuous improvement of care.
Did you like this article? Subscribe to our newsletter for more like this.
Een lerend zorgstelsel voor beter kankeronderzoek en betere zorg
Elke dag worden er enorme hoeveelheden data gegenereerd tijdens de diagnose en behandeling van kanker. Weefselmonsters worden geanalyseerd, DNA-gegevens worden verkregen, behandelingen worden voorgeschreven en uitkomsten worden gemonitord. De inzichten verkregen uit deze data zijn waardevol voor individuele patiënten. Mits de rechten en keuzes van patiënten ten aanzien van het gebruik van hun gegevens worden gerespecteerd, kunnen ze ook onderzoek en innovatie aandrijven om de zorg voor toekomstige patiënten te verbeteren. Het verbeteren van deze ‘dataloop’ is een gedeelde missie van Hartwig Medical Foundation en het Patient Cohorts Platform van Oncode Accelerator. Samen willen zij reguliere kankerzorg omvormen tot een lerend zorgstelsel dat onderzoek versnelt, beslissingen rondom de behandeling verbetert en betere kankerzorg biedt aan toekomstige patiënten.
Een geïntegreerd lerend zorgstelsel waarin iedere patiënt bijdraagt aan betere kankerzorg voor de volgende generatie patiënten. Dat is de gedeelde toekomstvisie van Hartwig Medical Foundation en het Patient Cohorts Platform van Oncode Accelerator. Samen werken zij aan het verzamelen en koppelen van gegevens uit het volledige zorgtraject van mensen met kanker, waaronder longitudinale klinische gegevens, uitkomstgegevens, genetische informatie en gegevens over kwaliteit van leven. Deze data kunnen niet alleen de diagnose en behandeling van patiënten ondersteunen, maar ook bijdragen aan de ontwikkeling van nieuwe therapieën.
We spraken met Paul Roepman (Klinisch Moleculair Bioloog, Hartwig Medical Foundation), Joep de Ligt (Database Lead, Hartwig Medical Foundation) en Elise Rinzema (Programmamanager, Patient Cohorts Platform van Oncode Accelerator) om meer over de activiteiten van beide organisaties te leren.
“Ieder van ons draagt een ander stukje van de puzzel bij,” legt Elise uit. Het Patient Cohorts Platform brengt twaalf landelijke oncologische cohorten samen die hoogwaardige klinische gegevens en biomaterialen verzamelen van kankerpatiënten in Nederland. Hartwig Medical Foundation is gespecialiseerd in het analyseren van het DNA van het volledige kankergenoom en het vertalen van deze complexe moleculaire gegevens naar informatie die relevant en bruikbaar is voor artsen, patiënten en onderzoekers. Paul vult aan: “Hartwig Medical Foundation is een technologisch instituut. We zijn afhankelijk van samenwerkingen met ziekenhuizen, bij voorkeur op grote schaal zoals met het Patient Cohorts Platform, want aantallen doen ertoe.”
Van reguliere zorg naar een lerend zorgstelsel
“In elk ziekenhuis is zoveel data beschikbaar. Idealiter haal je daar inzichten uit om onderzoek en toekomstige zorg te verbeteren, vervolgens de behandeling voor toekomstige patiënten te verbeteren, en dan weer te leren van de patiënten die deze verbeterde behandelingen krijgen,” zegt Elise. “Maar onderzoek en reguliere zorg opereren vaak los van elkaar. Om ze samen te brengen is coördinatie en vertrouwen nodig.”
Elise Rinzema, programmamanager, Patient Cohorts Platform van Oncode AcceleratorIn elk ziekenhuis is zoveel data beschikbaar. Idealiter haal je daar inzichten uit om onderzoek en toekomstige zorg te verbeteren, vervolgens de behandeling voor toekomstige patiënten te verbeteren, en dan weer te leren van de patiënten die deze verbeterde behandelingen krijgen. Maar onderzoek en reguliere zorg opereren vaak los van elkaar. Om ze samen te brengen is coördinatie en vertrouwen nodig.
Diagnostische informatie helpt bijvoorbeeld bij het nemen van beslissingen voor individuele patiënten, maar het potentieel ervan om nieuwe inzichten te genereren en behandelingen voor toekomstige patiënten te verbeteren, wordt niet altijd volledig benut. Klinische studies blijven essentieel voor de ontwikkeling van nieuwe behandelingen, maar een lerend zorgstelsel kan deze versterken door systematisch te leren van alle patiënten die in de dagelijkse praktijk kankerzorg ontvangen.
“In een ideale situatie leer je van elke patiënt,” zegt Paul. “In een lerend zorgstelsel willen we weten of een behandeling werkte, voor wie en waarom. Die inzichten moeten terugvloeien naar onderzoek en zorg, zodat we kunnen leren van onze successen en fouten en de zorg voor toekomstige patiënten kunnen verbeteren.”
De dataloop sluiten
Het sluiten van deze dataloop tussen zorg en innovatie is een noodzakelijke stap op weg naar een lerend zorgstelsel. “Het gaat erom dat data die tijdens de zorg wordt gegenereerd, terugkomt in onderzoek, klinische studies en de herbeoordeling van geneesmiddelen,” legt Joep uit. “Data uit verschillende ziekenhuizen over hoe lang patiënten overleven na een bepaalde behandeling moet bijvoorbeeld worden verzameld, gecentraliseerd en geanalyseerd om te bepalen hoe goed de behandeling werkte. De bevindingen van die herbeoordeling moeten vervolgens weer terugvloeien naar behandelrichtlijnen.”
Joep de Ligt, Database Lead, Hartwig Medical FoundationHet sluiten van de dataloop gaat erom dat data die tijdens de zorg wordt gegenereerd, terugkomt in onderzoek, klinische studies en de herbeoordeling van geneesmiddelen. Data uit verschillende ziekenhuizen over hoe lang patiënten overleven na een bepaalde behandeling moet bijvoorbeeld worden verzameld, gecentraliseerd en geanalyseerd om te bepalen hoe goed de behandeling werkte. De bevindingen van die herbeoordeling moeten vervolgens weer terugvloeien naar behandelrichtlijnen.
Paul en Joep geven twee voorbeelden van hoe deze feedbacklus patiënten ten goede kan komen. Het eerste voorbeeld betreft PARP-remmers, een behandeling voor patiënten met borst- of eierstokkanker. “Traditioneel dacht men dat PARP-remmers het best werkten bij patiënten met borst- of eierstokkanker met mutaties in de BRCA-genen. Dat kwam ook tot uiting in de richtlijnen voor het gebruik van een geneesmiddel,” legt Paul uit. “Maar door whole genome sequencing (een techniek waarmee de volledige DNA-code in kaart wordt gebracht) -data van patiënten te analyseren, hebben we geleerd dat PARP-remmers goed werken tegen tumoren met veel DNA-breuken, die wel, maar niet uitsluitend, door defecten in BRCA-genen kunnen worden veroorzaakt. PARP-remmers werken minder goed bij tumoren met weinig DNA-breuken, zelfs als er wel een BRCA-mutatie aanwezig is.” Dit nieuwe inzicht kan artsen in de toekomst helpen beter onderbouwde behandelkeuzes te maken en bijdragen aan het aanpassen van de gebruiksvoorschriften.
Een tweede voorbeeld is kanker van onbekende primaire origine (Cancer of Unknown Primary, CUP): gevallen waarin kanker is uitgezaaid, maar de oorsprong niet kan worden vastgesteld. Dat betekende voorheen dat er geen standaardbehandeling beschikbaar was, omdat behandelschema’s, waaronder chemotherapieën, worden afgestemd op de plaats van de oorspronkelijke tumor. “Met behulp van whole genome sequencing-data kunnen we nu bij ongeveer drie op de vier patiënten met CUP beter begrijpen waar de primaire tumor zit,” aldus Paul. Deze aanpak, die inmiddels in de Nederlandse zorg wordt vergoed, opent behandelmogelijkheden voor patiënten die anders geen opties hadden.
Waar de dataloop nog hapert
Om conclusies te kunnen trekken, moeten zowel biologische monsters als klinische informatie aan hoge kwaliteitsnormen voldoen. Bij biologische monsters zijn de manier van afname en opslag cruciaal. Voor routinematig weefselonderzoek moeten monsters bijvoorbeeld worden verwerkt met formaline-fixatie voor microscopisch onderzoek. Dit proces beschadigt echter het DNA, waardoor deze monsters minder geschikt zijn voor analyse met whole genome sequencing. Data van biologische monsters en de bijbehorende klinische data van dezelfde patiënt moeten bovendien aan elkaar gekoppeld worden, zodat duidelijk is welke monsters bij welke patiënt horen.
Bij klinische data is het belangrijk dat informatie nauwkeurig, volledig en gestandaardiseerd wordt vastgelegd. “Als overlevings- of behandeldata onnauwkeurig of onvolledig is,” legt Joep uit, “lopen onderzoekers het risico verkeerde conclusies te trekken.”
Standaardisatie van data is ook essentieel om data uit verschillende ziekenhuizen effectief te kunnen combineren. “We moeten allemaal dezelfde taal spreken,” zegt Elise. “Door verschillende datasets te kunnen combineren, wordt de data veel waardevoller.” Standaardisatie maakt het bijvoorbeeld makkelijker om zeldzame vormen van kanker en specifieke patiëntsubgroepen te bestuderen, zoals patiënten met bepaalde moleculaire profielen of behandelresponsen, waarvoor vaak slechts beperkte hoeveelheden data beschikbaar zijn. Wanneer gegevens uit verschillende bronnen op een gestandaardiseerde manier worden verzameld en gekoppeld, kunnen datasets van voldoende omvang worden samengebracht, zowel nationaal als internationaal. Dit maakt het mogelijk om betekenisvol bewijs te genereren waar dat anders niet haalbaar zou zijn.
Complexe data begrijpelijk maken
Elke whole genome sequencing-dataset bevat een enorme hoeveelheid informatie. Paul zegt hierover: “Een deel van mijn rol is ervoor te zorgen dat de gegenereerde genomische data en resultaten aansluiten bij wat ziekenhuizen nodig hebben, willen en aankunnen, om artsen te ondersteunen – en niet te verwarren – bij een zinvol gesprek met hun patiënten in de spreekkamer.” Om de hoeveelheid informatie hanteerbaar te maken, richt de Hartwig Medical Foundation zich daarom op enkele honderden genetische kenmerken en signalen die klinisch relevant zijn voor het type tumor en de mogelijke behandeling.
Paul Roepman, klinisch moleculair bioloog, Hartwig Medical FoundationEen deel van mijn rol is ervoor te zorgen dat de gegenereerde genomische data en resultaten aansluiten bij wat ziekenhuizen nodig hebben, willen en aankunnen, om artsen te ondersteunen – en niet te verwarren – bij een zinvol gesprek met hun patiënten in de spreekkamer.
Waarom rapporteren we alleen deze geselecteerde kenmerken en signalen, en niet alles? “Als je alle data uit whole genome sequencing zou willen bekijken, zou dat zelfs voor een expert dagen duren,” legt Joep uit. “We hebben het team van Paul nodig om te bepalen wat klinisch relevant is. Als het aantal genetische mutaties bijvoorbeeld voorspelt of een immuuntherapie bij een patiënt zal werken, is dat belangrijke informatie. Maar een arts wil geen ruw getal zien, die wil weten: gaat deze therapie mijn patiënt helpen?”
Om onderzoekers en behandelaars te helpen door die grote datasets te navigeren en praktische vragen te beantwoorden, zoals welke therapie bij welke patiënt zal werken, ontwikkelt het team van Joep bij Hartwig Medical Foundation nieuwe tools, zoals AI-assistenten die onderzoekers en artsen helpen de beschikbare data te gebruiken om hun vragen te beantwoorden.
Belangrijk is dat deze tools voor data-analyse en visualisatie zijn ontworpen met privacy als uitgangspunt. “Onze AI-assistent helpt vragen te beantwoorden op basis van de beschikbare data, maar heeft nooit rechtstreeks toegang tot patiëntgegevens,” legt Joep uit. Dit waarborgt naleving van strenge eisen voor gegevensbescherming en respecteert de toestemming van patiënten en hun recht om hun gegevens in te trekken. Het doel is om data makkelijker te kunnen analyseren zonder concessies te doen aan veiligheid of de privacy van patiënten.
Samen bouwen aan de toekomst
Het sluiten van de dataloop vraagt niet alleen om geavanceerde technologie en expertise, maar ook om vertrouwen en intensieve samenwerking. Gegevens moeten op dezelfde manier worden vastgelegd, systemen moeten op elkaar aansluiten en organisaties moeten afspraken maken over hoe data veilig en verantwoord wordt gedeeld. Dat kost tijd en inzet, maar de mogelijke voordelen voor patiënten zijn groot. Hartwig Medical Foundation en het Patient Cohorts Platform brengen ieder een essentieel stukje van de puzzel. Samen werken zij aan een toekomst zorgstelsel waarin de kennis die ontstaat tijdens de zorg van vandaag, helpt om de zorg voor toekomstige patiënten verder te verbeteren.
Photo credit: Laloes Fotographie
Over Hartwig Medical Foundation (Hartwig)
Hartwig Medical Foundation is een Nederlandse stichting die wereldwijd actief is met als missie de zorg voor kankerpatiënten te verbeteren. Zij ondersteunen datagedreven behandelbeslissingen met een combinatie van innovatieve software, klinische data-analyses en moleculaire diagnostiek. Zo ontvangen patiënten tijdig de juiste behandeling, terwijl er tegelijkertijd waardevolle informatie wordt gegenereerd die onderzoek, geneesmiddelenontwikkeling en de continue verbetering van zorg ondersteunt.